نظرة عامة على المشروع
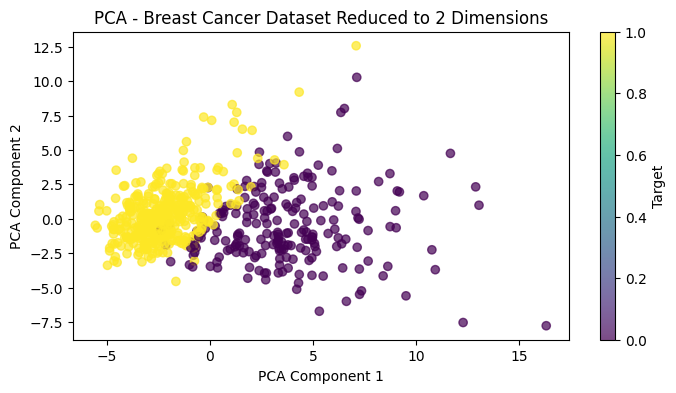
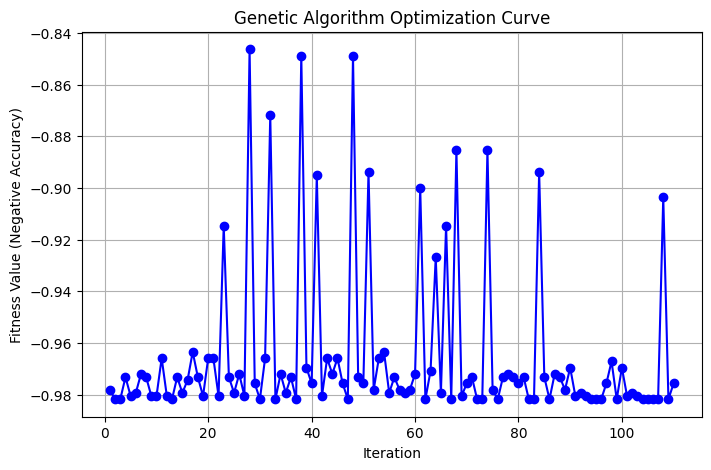
يقوم المشروع بتحميل مجموعة البيانات "heart.csv" إلى pandas، وينفذ المعالجة المسبقة القياسية (التوسع، وتقسيم التدريب والاختبار)، ثم يحدد مهمة تحسين عبر المعلمات الفائقة لـ RandomForestClassifier باستخدام خوارزمية وراثية من NIAPY وPSO من PySwarm وبالتوازي، يستخدم AutoKeras للبحث عن بنية شبكة عصبية مثالية (مبنية على TensorFlow) ويقارن كلا النهجين عبر الدقة ومصفوفات الارتباك وتقارير التصنيف.
معاينة الملف / المشروع
مشاريع ذات صلة


معلومات المشروع
التصنيف
تعلم آلي
تاريخ الإنجاز
02/05/2025
التقنيات المستخدمة
Python 3
Jupyter Notebook
pandas
NumPy
NIAPY GeneticAlgorithm
PySwarm PSO
scikit-learn
matplotlib